Maîtrise de l'IA
Les langues ne se valent pas face à l'IA
La tokenisation n'est pas neutre. Le français consomme plus de tokens que l'anglais pour exprimer la même idée — avec des conséquences directes sur le coût, la latence et la qualité.
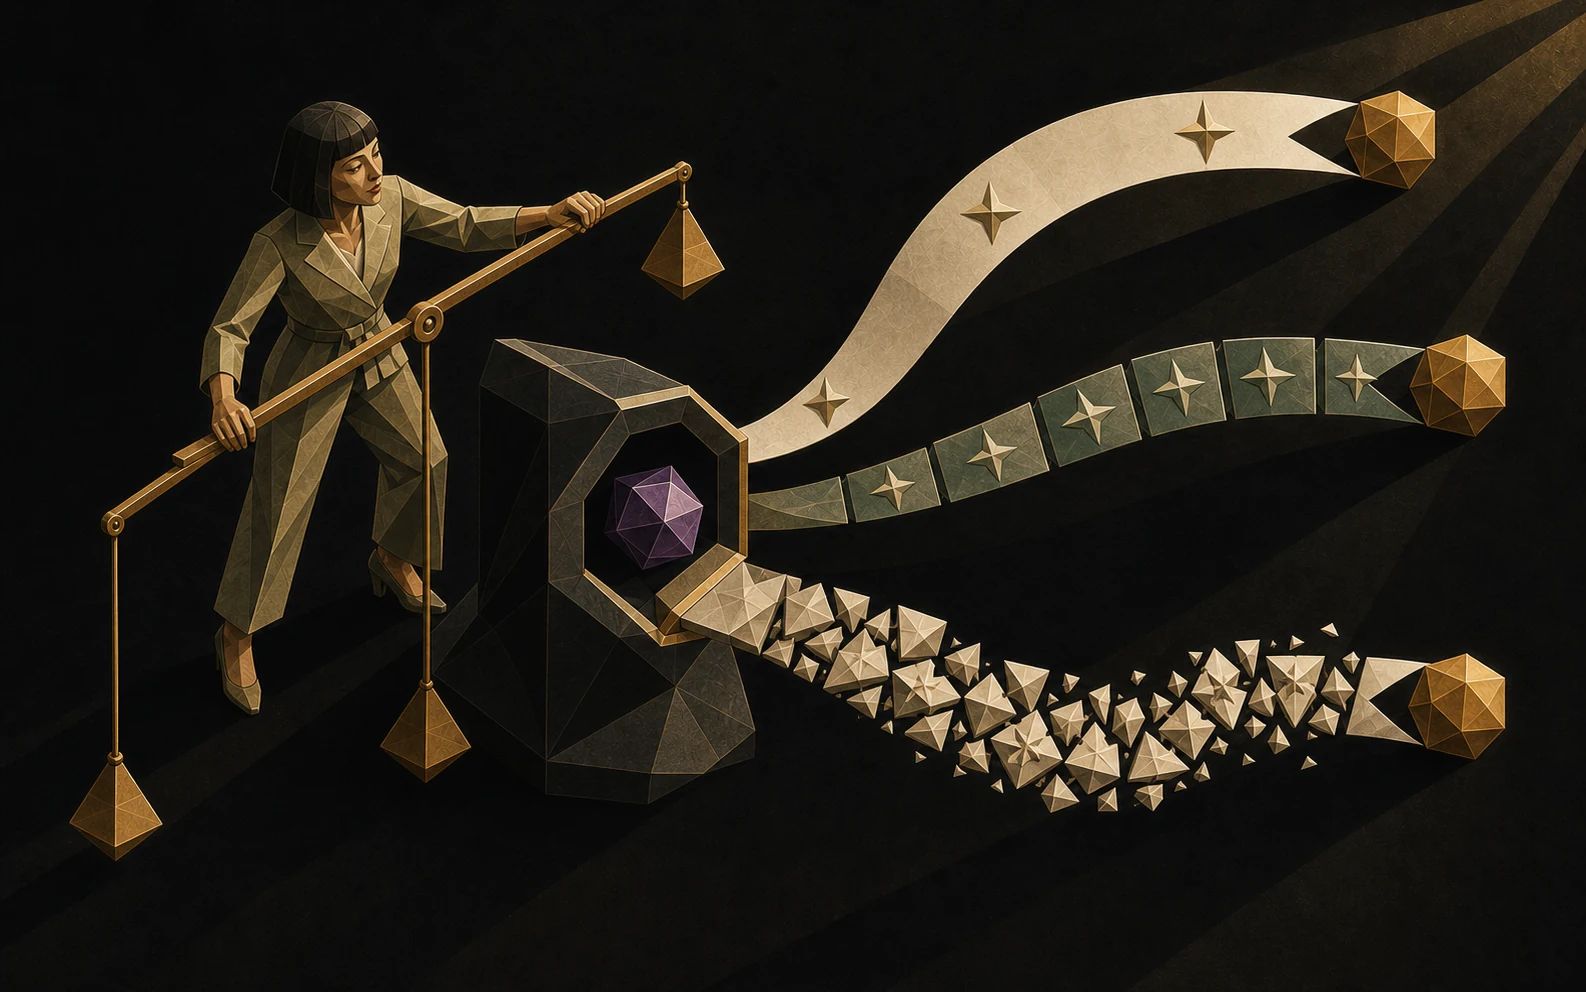
Constat contre-intuitif mais déterminant : rédiger vos prompts en anglais est souvent moins cher, plus rapide et légèrement plus précis qu’en français — y compris quand la sortie finale doit être en français. Cet article explique pourquoi, et quand ça compte.
Tokens, pas mots
Les modèles ne voient pas des mots. Ils voient des tokens — des fragments de sous-mots produits par un tokeniseur entraîné majoritairement sur du texte anglais. Pour l’anglais, le ratio est efficace : environ un token pour quatre caractères. Pour le français, l’allemand ou l’espagnol, le ratio se dégrade. Pour le mandarin ou le coréen, c’est encore plus marqué.
Trois exemples suffisent à saisir le phénomène. Le mot anglais « Apple » : 1 token. Le mot français « Élégance » : 2 tokens — « Élég » + « ance ». Le salut hindi « नमस्ते » : jusqu’à 6 à 10 tokens, parce que le tokeniseur doit le décomposer quasiment caractère par caractère. Ces comptes sont indicatifs — la tokenisation exacte dépend du modèle et de la version du tokeniseur — mais l’ordre de grandeur, lui, est structurel.
Rien d’aléatoire là-dedans. Les tokeniseurs sont entraînés majoritairement sur de l’anglais : Meta indique par exemple que le dataset d’entraînement de Llama 3 contenait environ 95 % d’anglais et de code. Le résultat est un vocabulaire très riche et très efficace pour l’anglais… et nettement moins efficace pour beaucoup d’autres langues.
La « taxe token »
Les chercheurs qui ont mesuré la consommation de tokens selon les langues utilisent une expression parlante : la « token tax », la taxe token. Les langues non anglophones portent une inflation structurelle — elles coûtent plus de tokens pour exprimer le même contenu sémantique. Pensez-y comme à un taux de change où l’anglais serait toujours la monnaie de réserve.
Deux études font référence sur le sujet : Petrov et al., « Language Model Tokenizers Introduce Unfairness Between Languages » (NeurIPS 2023), et Ahia et al., « Do All Languages Cost the Same? » (2023). Les chiffres exacts varient selon les modèles et les versions de tokeniseurs, mais la conclusion tient : à contenu égal, l’anglais est la langue la moins chère.
Pourquoi le chinois n’échappe pas à la taxe
On pourrait croire que le mandarin s’en sort mieux : c’est une langue très dense, où un seul caractère peut condenser un concept entier. Et pourtant, il paie une prime. La raison tient à ce qu’on peut appeler le paradoxe d’encodage UTF-8 : un caractère latin occupe 1 octet en mémoire, tandis qu’un caractère chinois standard en occupe 3. Or les tokeniseurs — souvent basés sur du byte-pair encoding — apprennent à partir de représentations en octets et de la fréquence dans les corpus. Un caractère très fréquent peut tenir en 1 token ; un caractère plus rare se fragmente en 2 ou 3. En pratique, la densité sémantique compense une partie de la taxe — mais ne l’annule pas.
Pourquoi ça compte vraiment : la fenêtre de contexte
Les tokens restent une abstraction… jusqu’au moment où l’on comprend que chaque modèle possède une fenêtre de contexte : une limite dure sur le nombre de tokens qu’il peut garder « en mémoire » à un instant donné. Et cette limite ne couvre pas que votre prompt — elle inclut aussi la réponse, les documents fournis et l’historique de la conversation.
Une fenêtre de 128 000 tokens — une taille courante aujourd’hui — permet à un utilisateur anglophone de charger l’équivalent d’un roman entier. La même fenêtre, remplie d’un document en arabe ou en hindi, peut n’en contenir qu’un tiers à un cinquième — et pour certaines langues très peu représentées dans les corpus, la littérature documente des écarts allant jusqu’à 15×. Même mémoire, capacité très différente.
L’effet sur la qualité du raisonnement est direct. Les tâches complexes — analyse juridique, synthèse, aide à la décision multi-étapes — reposent sur la capacité du modèle à conserver suffisamment de contexte pour raisonner de manière cohérente. Dans les langues « inflationnistes », le contexte se remplit plus vite : le modèle est forcé de tronquer, de compresser, ou de raisonner plus superficiellement. Vous payez, de facto, plus de calcul pour moins d’intelligence.
Un exemple que je donne souvent en atelier : vous chargez une note de politique publique de 20 pages en français et vous demandez une analyse détaillée. Comparée au même document en anglais, la version française consommera davantage de fenêtre de contexte rien que pour être lue — laissant moins de place à la couche de raisonnement. Le résultat peut devenir sensiblement plus générique.
Que faire concrètement
Comprendre la taxe token n’est pas un argument pour abandonner votre langue de travail. C’est un argument pour être délibéré : faire de la langue un paramètre de prompt engineering à part entière. Voici les quatre stratégies que j’applique et que je recommande.
1. Prompter en anglais pour les tâches de raisonnement complexes
Pour les tâches qui demandent un raisonnement structuré et multi-étapes — rédaction, analyse, classification, génération de code — prompter en anglais est souvent l’approche la plus efficace en tokens. La recherche va dans le même sens : une étude de l’EPFL (2024) sur Llama-2 suggère que les modèles raisonnent souvent via une représentation interne « proche de l’anglais », même quand on les interroge dans une autre langue. La nuance importante : l’écart se réduit avec les modèles récents, en particulier pour des langues européennes bien dotées comme le français.
Et rien ne vous oblige à recevoir la réponse en anglais. Un prompt comme « Analyze this document and identify the three main risks. Respond in French. » vous donne le meilleur des deux mondes : la qualité de raisonnement de l’anglais, la sortie en français.
2. Rester concis dans les langues « chères »
Chaque mot en plus, dans une langue coûteuse en tokens, consomme davantage de fenêtre de contexte. Soyez particulièrement concis en allemand, en arabe, ou dans d’autres langues morphologiquement complexes. Supprimez les politesses, le contexte redondant, les longues introductions. Allez droit à l’instruction.
3. Résumer les documents longs avant l’analyse en profondeur
Si vous devez travailler sur un document long dans une langue autre que l’anglais, demandez d’abord une synthèse concise — puis utilisez cette synthèse comme base pour l’analyse. Ce fonctionnement en deux temps réduit fortement la consommation de tokens avant même que le raisonnement ne commence.
4. Garder l’anglais pour les prompts « chain-of-thought »
Les techniques du type « réfléchis étape par étape » sont très gourmandes en tokens : elles demandent au modèle de raisonner à voix haute. Elles sont souvent plus efficaces en anglais, où elles épuisent moins vite le budget de contexte.
En résumé, la règle de décision que j’utilise :
- Pour vos prompts internes, travaillez en anglais quand vous le pouvez.
- Pour les livrables clients, rédigez dans la langue cible.
- Quand le coût prime, exécutez en anglais et faites traduire.
- Quand la nuance prime, rédigez en langue cible et acceptez le surcoût.
Le paramètre qu’on oublie : le choix du modèle
La taxe token n’est pas une fatalité, et le modèle que vous choisissez fait partie de la réponse. Des modèles d’origine européenne réduisent ce biais en entraînant leurs tokeniseurs sur des corpus mieux équilibrés : un modèle « né » en Europe peut apprendre à reconnaître davantage de mots français comme unités fréquentes, et donc réduire la fragmentation.
EuroLLM, lancé en septembre 2024 par un consortium de recherche financé par l’UE (Unbabel, University of Edinburgh, Instituto Superior Técnico, Université Paris-Saclay, entre autres) et entraîné sur le supercalculateur MareNostrum 5 à Barcelone, vise une couverture native des 24 langues officielles de l’Union. Son tokeniseur — un vocabulaire SentencePiece BPE de 128 000 sous-mots, entraîné sur l’ensemble du corpus multilingue — atteint une « fertilité » médiane de 1,2 à 1,4 token par mot sur les langues de l’UE, proche de l’anglais. Nuance honnête : EuroLLM reste un modèle de recherche, pas encore au niveau des meilleurs modèles commerciaux pour le raisonnement général. Sa force, c’est la couverture multilingue et l’équité de tokenisation.
Mistral AI avance sur le même front. Avec Mistral NeMo (2024), le laboratoire français a introduit Tekken, un tokeniseur entraîné sur plus de 100 langues avec un vocabulaire dix fois plus large que le précédent. Tekken est environ 30 % plus efficace sur plusieurs langues européennes — français, allemand, espagnol, italien — et deux à trois fois plus efficace sur le coréen et l’arabe. Conséquence directe : l’écart de coût entre anglais et français se réduit fortement sur les modèles Mistral récents. Les tokeniseurs récents des laboratoires américains, comme o200k_base utilisé par GPT-4o, corrigent eux aussi une partie du déséquilibre.
C’est une raison concrète pour laquelle l’infrastructure IA européenne compte, au-delà des débats politiques : l’efficacité linguistique est une décision d’infrastructure.
Un dernier conseil, le plus simple de tous : testez. Prenez un prompt que vous utilisez régulièrement, réécrivez l’instruction en anglais en terminant par « Respond in French », puis comparez les deux résultats. C’est le genre de constat qui change durablement une pratique.
À lire aussi
Maîtrise de l'IA • 2 oct. 2025 • FR
Quand ouvrir une nouvelle conversation IA, et quand continuer ?
La fenêtre de contexte est une ressource finie. Savoir quand réinitialiser et quand poursuivre est l'une des compétences les plus utiles en maîtrise de l'IA.
Maîtrise de l'IA • 18 sept. 2025 • FR
Comment repérer une hallucination avant qu'elle ne vous repère
Cinq signaux pratiques indiquant qu'une réponse d'IA est inventée, pour les lecteurs non techniques qui veulent faire confiance à leurs outils sans se brûler.
Maîtrise de l'IA • 4 sept. 2025 • FR
Pourquoi la manière d'écrire votre prompt change tout
Une plongée non technique dans l'attention, le contexte, et la raison pour laquelle le même modèle donne des réponses radicalement différentes à des questions presque identiques.