Technique
La préparation des documents, facteur clé de performance des systèmes RAG
La qualité d'un système RAG dépend fortement de la manière dont les sources sont nettoyées, structurées, segmentées, indexées et évaluées.
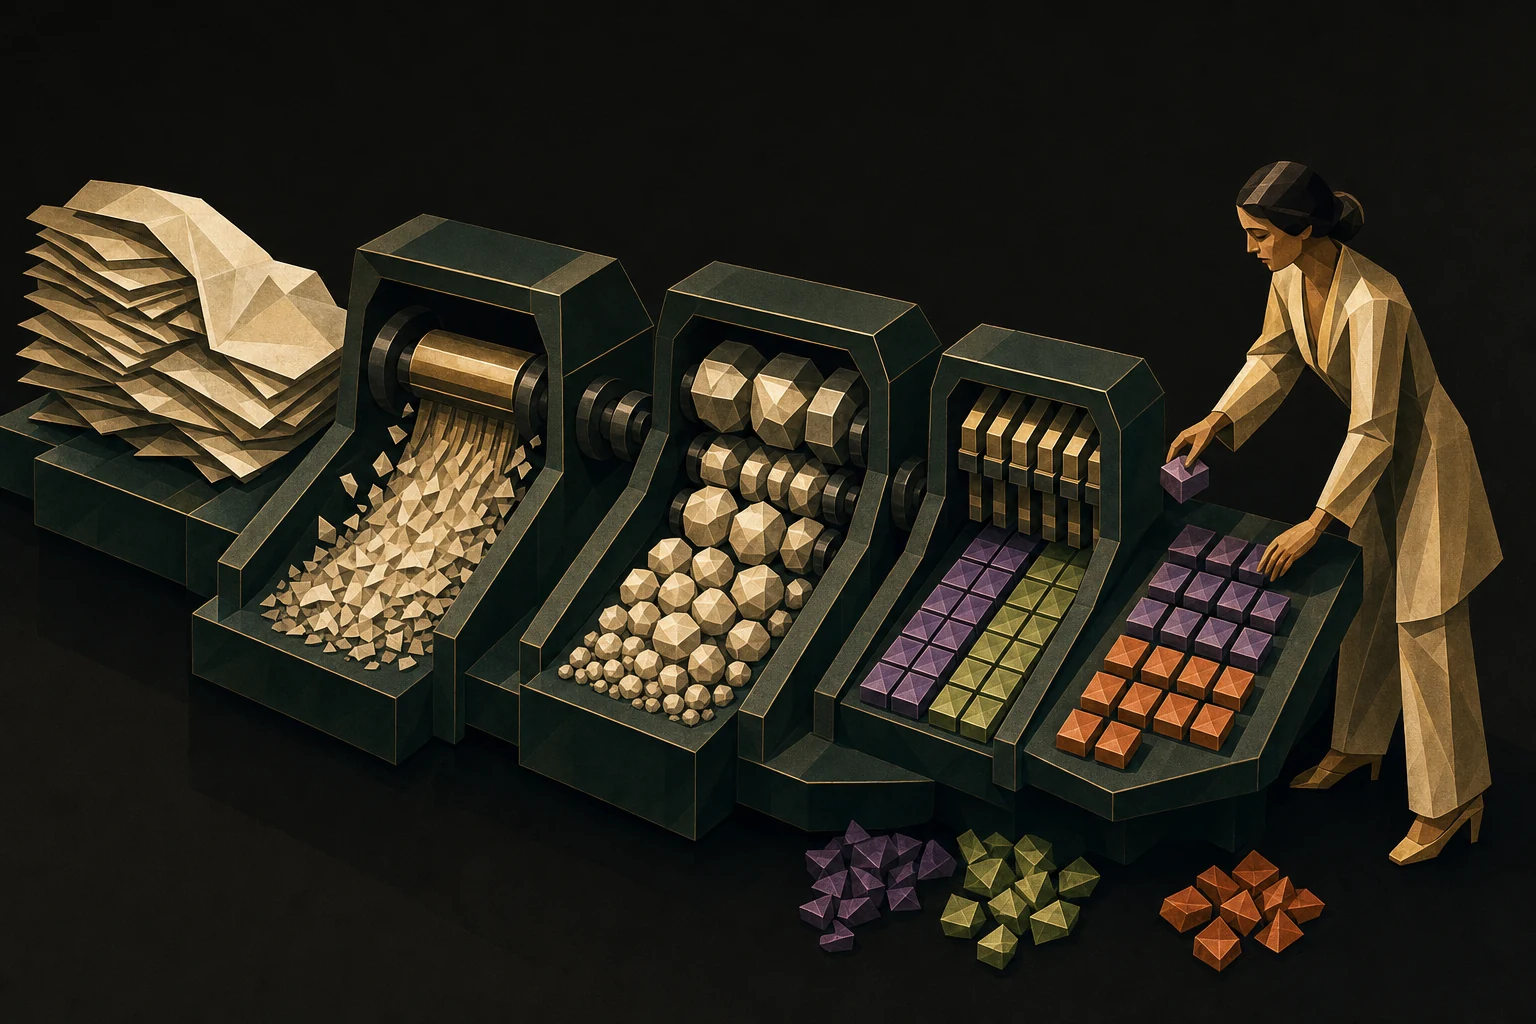
Les démonstrations RAG sont trompeuses : elles fonctionnent sur des corpus propres et bien étiquetés. En entreprise, les documents sont sales, contradictoires, mal structurés. Cet article décrit ce qui se passe en amont — et pourquoi c’est là que se joue la qualité.
RAG ne corrige pas vos données
Un système RAG (Retrieval-Augmented Generation) interroge une base de connaissances avant de générer une réponse. C’est puissant — mais ça hérite intégralement de la qualité de la base. Un PDF mal scanné, un tableau exporté sans en-têtes, un doublon non détecté : le modèle le reproduira fidèlement.
Les échecs que j’observe en production ont souvent la même origine : une défaillance dans la chaîne de préparation des documents, pas dans le modèle. Cette étape, parfois négligée au profit de l’optimisation du modèle, influence directement ce que le système peut retrouver et restituer. Son poids exact varie selon le corpus, la question et la méthode d’évaluation ; il n’existe pas de pourcentage universel.
Un exemple que je rencontre régulièrement : un tableau financier dans un PDF. Sans préparation adaptée, le système lit Revenus 2023 45,7 2024 52,3 — une chaîne de caractères sans structure. Impossible alors de répondre précisément à « Quelle est la croissance des revenus entre 2023 et 2024 ? ». Avec un preprocessing approprié, le tableau conserve sa structure, et les calculs comme les comparaisons deviennent fiables.
La préparation ne se limite donc pas à l’extraction de texte. Il s’agit de préserver le sens, le contexte et les relations entre les informations : maintenir la hiérarchie des sections, identifier les éléments structurants (titres, listes, tableaux) et enrichir le contenu avec des métadonnées pertinentes.
Le retour sur investissement doit donc se mesurer projet par projet : qualité de récupération sur un jeu de questions de référence, exactitude des réponses, coût par requête et capacité à retrouver la source utilisée. À l’inverse, un document mal préparé peut générer des réponses approximatives ou erronées, même avec un modèle performant.
Les cinq étapes de la transformation documentaire
Une approche systématique de la préparation suit cinq étapes, chacune avec sa valeur propre. Ensemble, elles transforment des archives inexploitables en capital intellectuel actif.
1. Extraction et normalisation
L’extraction doit traiter tous les formats en présence : Word avec ses styles et métadonnées, Excel avec ses formules, PowerPoint avec ses notes cachées, HTML avec ses balises — sans oublier l’OCR pour les documents scannés. La normalisation unifie ensuite ce contenu hétérogène : encodages, formats de dates, espaces, caractères spéciaux. Sans cette étape, la même information apparaît sous de multiples formes et compromet la recherche.
2. Nettoyage intelligent
Tous les contenus ne se valent pas. Les en-têtes répétitifs, les pieds de page, les mentions légales standard polluent l’index sans apporter de valeur. Un nettoyage intelligent préserve l’information utile tout en éliminant le bruit. Attention toutefois : dans certains contextes juridiques, ces éléments « parasites » peuvent être cruciaux. Le nettoyage se paramètre par corpus, jamais en aveugle.
3. Structuration sémantique
Les documents d’entreprise suivent souvent des patterns récurrents : un rapport annuel contient toujours une section finances, une section stratégie, une section risques. Identifier et baliser ces structures permet au système de naviguer intelligemment dans le corpus. La structuration peut être explicite (balises XML) ou implicite (découpage intelligent).
4. Enrichissement contextuel
Ajouter des métadonnées transforme un document passif en source active. Date de validité, auteur, département, niveau de confidentialité, version : ces informations permettent un filtrage fin lors des recherches. L’enrichissement peut aussi inclure des éléments dérivés — analyse de sentiment pour les rapports d’audit, extraction d’entités nommées pour les contrats.
5. Découpage optimisé
Le chunking est l’étape la plus délicate : il détermine directement la granularité des réponses et leur précision. Un découpage trop large noie l’information pertinente dans du contexte superflu — demander le taux de croissance du T3 retourne trois pages d’analyse économique. Un découpage trop fin fragmente le sens — une définition légale coupée en plein milieu devient inexploitable.
Une stratégie robuste ne s’arrête pas à une règle rigide, par exemple des segments de 512 tokens. Elle compare plusieurs découpages selon la structure du corpus et les questions attendues. Des travaux sur des rapports financiers et des documents industriels montrent l’intérêt d’un découpage sensible à la structure, mais aussi que le résultat dépend fortement du type de document et du protocole d’évaluation (Sarthi et al., 2024 ; Taiwo et Yusoff, 2026).
Le découpage peut aussi maintenir des liens contextuels. Chaque segment peut porter une référence à ses voisins immédiats, ce qui permet au système d’élargir le contexte si nécessaire : une question sur une clause contractuelle peut ainsi récupérer les définitions du préambule ou les conditions des articles adjacents. Cette option doit être comparée à un découpage plus simple sur un jeu de questions représentatif du corpus.
Adapter le traitement au type de contenu
Appliquer le même traitement à un contrat juridique et à un rapport technique garantit des résultats médiocres. Chaque type de document exige une approche spécifique.
Documents structurés (Excel, bases de données)
Plutôt que de linéariser brutalement les données tabulaires, générez des descriptions textuelles des relations : « Le chiffre d’affaires de la région Europe a augmenté de 15 % entre T3 et T4 2024 » est bien plus exploitable que Europe T3 45M T4 51.75M. Conservez néanmoins les données brutes pour les requêtes précises.
Documents légaux et contractuels
La hiérarchie est cruciale : articles, sections et sous-sections forment une arborescence qu’il faut respecter. Les références croisées (« voir article 4.2 ») doivent être résolues, ou au minimum tracées. Les définitions en début de document conditionnent l’interprétation de tout le reste — elles méritent un traitement prioritaire.
Documents techniques et scientifiques
Les formules, graphiques et schémas portent souvent l’information clé ; ne pas les traiter, c’est perdre l’essentiel. Les formules peuvent être converties en LaTeX ou MathML. Les graphiques nécessitent soit une description textuelle générée, soit une extraction des données sous-jacentes quand c’est possible.
Présentations et supports visuels
Les PowerPoint et PDF de présentation mélangent texte, images et mises en page complexes, et l’ordre de lecture n’y est pas toujours évident. Une analyse de layout permet de reconstituer le flux logique de l’information. Quant aux notes de présentation, souvent négligées, elles contiennent parfois plus d’informations que les slides elles-mêmes.
Automatiser sans perdre en précision
Face aux volumes, l’industrialisation de la préparation est inévitable. Mais automatiser ne signifie pas renoncer à la qualité : les meilleures architectures combinent traitements automatiques et contrôles ciblés.
Des pipelines modulaires. Construisez des chaînes de traitement composables, où chaque module a une responsabilité claire : extraction, nettoyage, structuration. Cette modularité permet d’adapter le pipeline par type de document sans tout reconstruire. Elle facilite aussi le débogage : quand une réponse est incorrecte, on remonte le problème à une étape précise.
Du machine learning dans la chaîne. Des modèles de classification routent automatiquement les documents vers le bon pipeline ; des modèles de NER (Named Entity Recognition) enrichissent les métadonnées ; des modèles d’analyse de layout structurent les documents complexes. L’IA n’intervient pas seulement dans la réponse finale : elle optimise toute la chaîne.
Une validation par échantillonnage. L’automatisation totale est un mythe dangereux. Sur chaque lot de documents traités, vérifiez manuellement un échantillon. Les patterns d’erreur détectés servent à affiner les règles de traitement — cette boucle de feedback maintient la qualité dans le temps.
Un circuit pour les exceptions. Tous les documents ne rentrent pas dans les pipelines standards : documents multilingues, formats exotiques, contenus mixtes. Bien gérées, ces exceptions deviennent des opportunités d’amélioration du système global.
Mesurer la qualité de la préparation
La qualité du preprocessing se mesure avec des métriques spécifiques, distinctes des métriques RAG classiques. Cinq indicateurs guident l’amélioration continue :
- Complétude de l’extraction — quel pourcentage du contenu original est effectivement extrait et indexé ? Les outils de diff permettent de comparer automatiquement source et résultat. Une extraction à 95 % peut sembler correcte, jusqu’à découvrir que les 5 % manquants sont les tableaux de chiffres clés.
- Préservation de la structure — les relations hiérarchiques sont-elles maintenues ? Test simple : peut-on reconstruire la table des matières originale à partir des chunks ? Si non, la structuration est insuffisante.
- Richesse des métadonnées — comptez le nombre moyen de métadonnées par document, et surtout mesurez leur utilisation réelle dans les requêtes. Des métadonnées non utilisées sont du gaspillage ; des filtres fréquemment demandés mais absents, des opportunités manquées.
- Temps de traitement vs qualité — la préparation a un coût en temps et en ressources. Parfois, 80 % de qualité en temps réel vaut mieux que 95 % avec 24 heures de délai ; d’autres fois, la précision prime sur la vitesse. Mesurez et arbitrez selon vos priorités métier.
- Impact sur les réponses finales — la métrique ultime reste la qualité des réponses. Mettez en place des tests de non-régression : un ensemble de questions de référence avec leurs réponses attendues, contre lequel tout changement de preprocessing est validé.
La checklist préparation
Pour synthétiser, voici les cinq points que je vérifie systématiquement avant d’indexer un corpus :
- Nettoyage — OCR de qualité, suppression des pieds de page, normalisation des encodages.
- Segmentation — découpage sémantique, pas mécanique.
- Métadonnées — date, source, statut (en vigueur / périmé).
- Déduplication — deux versions du même document = deux votes contradictoires.
- Évaluation — un jeu de questions/réponses de référence avant toute mise en production.
La préparation des documents n’est pas une étape technique parmi d’autres. C’est le fondement sur lequel repose toute la valeur de votre système RAG — les organisations qui l’ont compris investissent autant dans leur pipeline de preprocessing que dans leurs modèles.
À lire aussi
Technique • 14 juil. 2026 • FR
Vos agents IA n'ont pas un problème d'objectif. Votre organisation, si.
Confiez vos objectifs d'entreprise à un agent IA : il échoue instantanément, pour des raisons qu'un ingénieur sait nommer. Les mêmes que vos équipes absorbent en silence depuis des années.
Technique • 30 juin 2026 • FR
Des prompts aux boucles : le glissement en quatre couches que votre stratégie IA n'a pas encore rattrapé
Prompt, context, harness, loop engineering. Chaque couche vendue comme une spécialité technique est une discipline organisationnelle dont votre entreprise avait besoin avant même l'IA.